
从回答问题到完成工作:Nomi 的 Agent 实践
套壳 LLM 用久了会有个共同的感受:它很会聊,但什么也干不了。你问它这个季度的排期,它只能告诉你”建议查看项目管理工具”。
Nomi 是我做的一个面向企业员工的 AI 工作台,试图解决的就是这件事:以聊天为入口,但把个人知识、企业系统、办公文件、待办和定时任务都变成它能真正调用的能力。
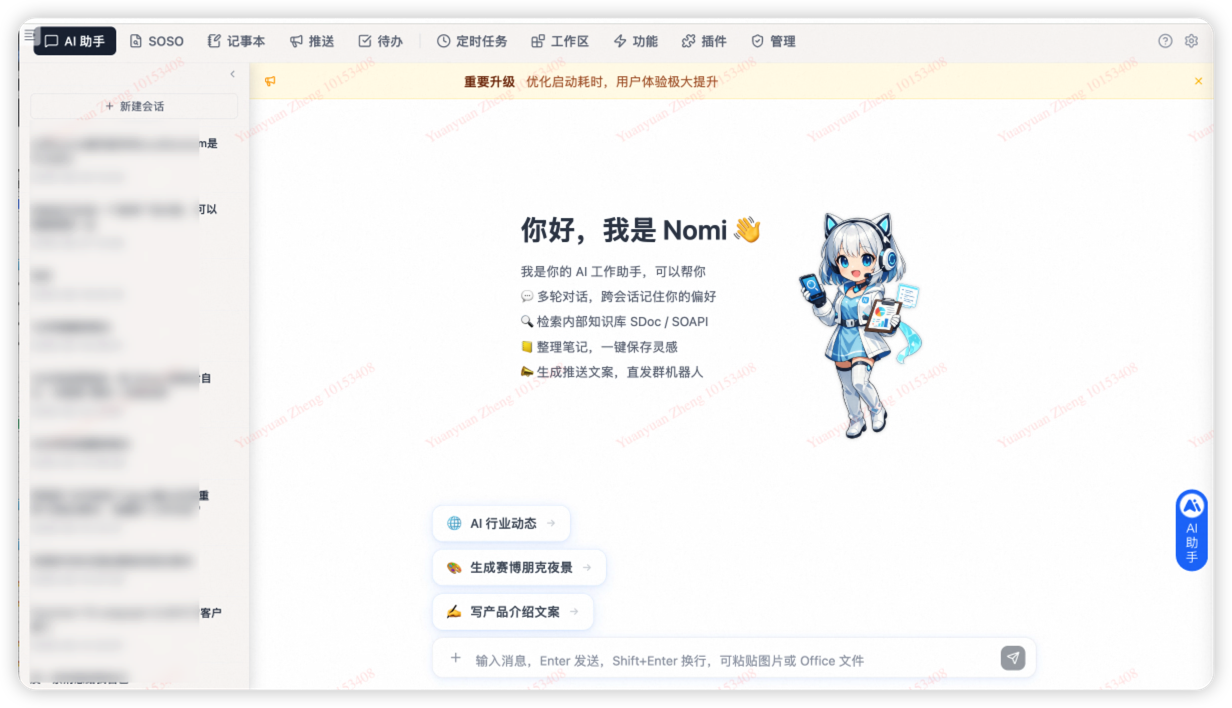
真正做下去会发现,“让它能动手”只是上半场。一旦 AI 能删你的文件、发你的邮件、改你的工单,怎么管住它就成了更难的那一半。
一句话背后有多少个系统
“帮我把这周的进展整理一下”,听起来是一件事。拆开是六件:翻知识库找到相关文档、读几份周报、把表格里的数字提出来、写成笔记、建下周的待办、设一个周五的提醒。
这六件事散落在四五个系统里。人做这件事,代价是不停切窗口、复制粘贴、来回找上次那个链接。而如果这些能力对 AI 来说也是彼此隔离的,它顶多帮你完成其中一件,剩下五件你还得自己来——那就没什么意义。
所以这套系统真正要解决的不是”模型够不够聪明”,而是让一次任务能在同一个上下文里走完。
给模型的不只是聊天记录
大多数对话产品传给模型的就是历史消息。但一个员工问”帮我把这周的进展整理一下”,历史消息里什么都没有。
所以除了对话,我还会往上下文里注入几样东西:
- 用户的工作区文档——偏好、角色设定、常用模板都在这里
- 分层的语义记忆
- 最近几次工具调用的结果
- 当前上传的 Word、Excel 内容
- 跨会话的摘要,省得每次重新交代背景
模型看到的不是一段孤立的对话,而是”这个人现在的工作状态”。
这也是整套系统里最花力气的地方——不是接模型,是决定每一轮该把什么塞进去。上下文是有预算的,塞多了贵且慢,塞少了它就开始编。
能力做成插件,而不是写死
在 Nomi 里,插件是一个很重要的概念——整个 Agent 几乎都是围绕插件搭起来的。插件是一组工具的集合,分两类:内置插件,比如记忆操作、问答、上下文管理;业务插件,比如内网搜索、文件解析、第三方服务。
工具是 Agent 执行的最小单元,它不是一个个硬编码进去的,而是有一套标准的定义流程。每个工具都有自己的描述文件,每份描述除了”这个工具是什么、怎么执行”,还要说清楚四件事:
- 适合哪个任务领域
- 要不要用户显式开启
- 要不要企业身份授权
- 风险等级是读取、写入、外发还是删除
执行方式可以是内置函数、企业内部服务代理,也可以是一个 HTTP 接口。
这么做的好处是加新能力基本只需要新增一份描述并注册进去,不用动主流程。Nomi 已经覆盖的能力大致是:知识搜索、笔记、网页搜索、图像生成、日程、工单、云盘、内部通讯、办公文件和待办。
这里把风险等级写进描述里有个额外的好处:能力开放变成了可以配置的事。哪些工具对哪些人可用、哪些必须走审批,是企业自己定的,不用交给模型临场判断。
怎么决定用哪个工具
工具多了之后有个很现实的问题:把几十个工具的描述一股脑塞给模型,它会挑花眼,而且光是工具描述就吃掉大量上下文。
我的做法是逐层收窄。先根据关键词和前几轮对话,判断这次任务大致属于哪个领域——通用、工作区、还是办公文件;再让模型解析一次意图,把用户想做的事映射到几个候选能力上;最后只把相关且当前可用的那几个工具交给它。一些内置的重型工具甚至是按需加载的,用不到就不进上下文。
从”全都给它”到”只给这几个”,模型的选择质量有明显提升。约束反而让它更准。
分领域还有个长远的好处:每个领域可以各自演进成更专的 Agent,而不用动整体结构。
按风险放行:读操作直接执行,写操作必须确认
这是整个系统里我最愿意讲的一个设计。
一开始的想法很朴素:既然 AI 会犯错,那所有操作都让用户确认一遍。做出来才发现根本没法用——查个日程弹一次确认,搜个文档弹一次确认,用户第三次就开始无脑点”同意”了。确认框一旦变成噪音,它就不再是一道防线。
后来改成按风险分级:
- 读操作直接执行。 查询、搜索、读取,错了也就是浪费一次调用,重来即可。
- 写操作需要确认。 建工单、改日程、写文件——会留下痕迹,但还能撤。
- 外发和删除永远需要确认。 发消息、发邮件、删数据。这类操作没有撤销键,别人已经收到了,文件已经没了。
分级之后确认框的出现频率降了一个数量级,而它每次出现都确实值得停下来看一眼。 说到底是一句话:AI 可以主动推进工作,但不能替你静默做不可逆的决定。
让它知道什么时候停
Agent 最典型的失败不是做错事,是停不下来。搜一次没找到就换个词再搜,读一个文件不满意就再读一个,可以一直转下去,把预算烧完。
所以每一轮工具调用之后都会检查几件事:是不是在重复调用同一个工具、搜索次数有没有超预算、读取量有没有超预算。触发了就中断循环,让模型基于已经收集到的证据直接给结论——给一个”根据目前查到的信息,大概是这样”的答案,比转到超时然后什么都没有要好。
换个说法:“停下来”本身得是一种能力,而不是失败。 一个成熟的 Agent 不该为了显得努力而一直搜下去,它该在合适的时候说清楚:查到了什么、没查到什么、下一步你可以怎么办。
同时每次任务都有完整的调用链路记录和 Token 统计,出问题能倒回去看它到底走了哪一步。
记忆分三层
长期记忆存稳定的事实——这个人是谁、在做什么项目、有什么偏好。情境记忆存近期的、会过期的东西。会话摘要单独存,用来在对话变长之后压缩前文。
检索靠向量相似度,配合访问热度做加权,再定期把相似的记忆聚类压缩掉。这层的目标不是”记住一切”,而是在上下文长度和长期个性化之间找一个能长期跑下去的折中。
一点收尾
回头看,这个项目真正困难的部分,几乎都不在模型本身。接入模型反而是最简单的一步。更难的是:每一轮该把什么放进上下文,哪些操作可以放行,以及什么时候该让它停下来。
也是在这个过程中,我重新理解了什么叫“好用”。
最初,我只是想帮助同事更好地写 Prompt。后来逐渐意识到,真正能够提升生产力的,不只是更好的提示词,而是丰富的工具,以及便捷访问内网服务的能力。于是,Nomi 里开始出现越来越多的小组件和内网插件。
但工具并不是越多越好。前面那套逐层收窄的做法,就是被这个问题逼出来的。
所以 Nomi 真正要解决的,并不是“拥有多少工具”,而是能否准确理解用户意图,只为当前任务加载真正必要的能力。
少做无关的事,完成真正重要的事。
正如 Nomi 的 Slogan 所说:Less Doing, More Done.
这个系列
这篇是总览。三个部分各展开写了一篇: