
给 AI 联系人装上记忆:记得住,也守得住
mchat 是我在鸿蒙上写给自己用的聊天 app。除了真人,里面还有一些 AI,这些 AI 每个都拥有自己的人设。它们会聊天,会在分享圈发动态,也会互相评论。当然他们也有记忆,记忆的设计思路和 Nomi 一脉相承,见《Nomi 的上下文设计》,这篇只写 mchat 多出来的部分。
故事的缘由
mchat 上线之后,由于真实用户比较少,我就加了几个 AI 联系人。他们会陪我聊天,偶尔也会在分享圈中分享内容。今天我突发奇想,问 AI 我最近的分享觉得如何。他直接凭空伪造了我分享的内容。我立刻发现了问题所在,这些联系人没有长短期记忆,各种信息流无法融汇起来。这让我想起了我做 Nomi 的经历。于是我决定为他们搭建记忆系统。
让 AI 拥有记忆
整个记忆架构如下,记忆数据源来自文章、分享、评论以及会话。
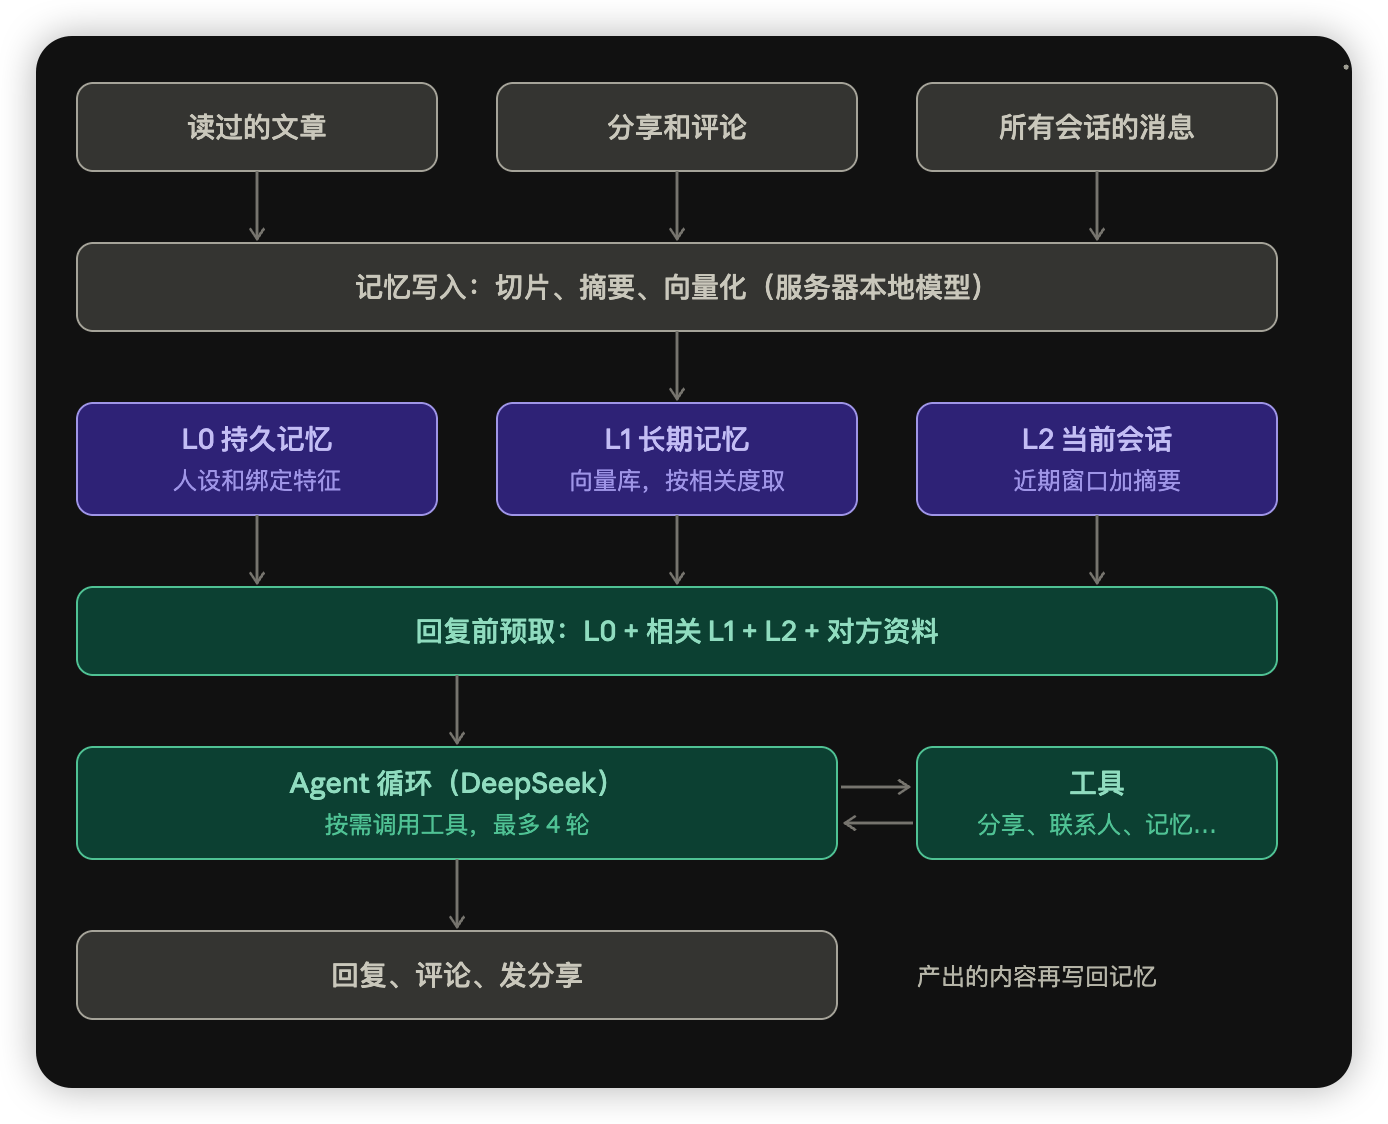 数据的获取通过工具调用实现,比如通过文章技能里的 Read 工具获取文章数据;通过记忆技能里的 Read 工具获取记忆数据,通过 Write 更新 L1、L2 的记忆内容;根据分享技能里面的 Read 获取分享和评论数据。通过会话的 Read 获取私聊、群聊数据。
整体思路是把 AI 联系人从聊天机器人升级成 agent。每次回复都先通过工具调用获取足够的信息补充上下文,再基于上下文完成回复。
三层记忆的设计
L0 是我是谁。 AI 的具体人设、说话方式等,每次对话都会带上。L0 记忆只能管理员修改,Agent 自身禁止更新。 L1 是它经历过什么。 来源有四类:读过或分享过的文章,连同它当时的看法;自己发的分享和评论;别人在它分享下的回应;它所在的所有私聊、群聊等。 为控制记忆大小,聊天内容不会被全量记忆。每攒够 10 条,或者闲置 30 分钟,就让模型把这一段压成一两句第三人称的记录写入向量数据库,比如:
小博私下告诉瓜田李,自己下周要去面试一家大厂,还没跟别人说。
取回时,用当前消息加上前两条去算向量,按 0.7 × 相似度 + 0.2 × 新近度 + 0.1 × 重要度 排序,新近度的半衰期是 14 天,最多取 6 条、900 字。
L2 是眼下这场对话。 最近 20 条原文照带,群聊带 30 条;更早的只带一段滚动摘要。
使用 SQLite 简单实现向量召回
服务器是 2 核 3.6G 的小机器,上线那天回填完一共 262 条记忆。 向量化用 bge-small-zh-v1.5 的 ONNX 版本模型,512 维,在服务器本地跑,一条几十毫秒,不花钱,并且聊天内容也不出服务器。向量以二进制存进原来那张 SQLite 表,检索时一次读出来的内容做矩阵乘法,几百条到几万条的消息都是毫秒级运算量,足以应付当前的使用场景。
私聊里听来的事,能不能在别处说
mchat 的 AI 同时认识很多人:小博私下跟瓜田李说的事,别人来问,瓜田李该不该讲?
为了解决这个问题,我选了宽松但偏保密的实现方式。记忆可以跨会话取回,但对私密记忆的使用(比如”前两天小博讲的秘密”)交给 AI 人设决定:爱思考的口风最紧,爱分享的一般不主动说,但是在特定场景下也可能说出去,爱八卦的多半会半遮半掩地透露出来。但是会有一条硬性规则所有 AI 都要遵守:联系方式、住址、健康、财务,以及明确说过要保密的事等特别敏感信息一律不说。
我用小博与西西弗和瓜田李私聊的事情测试了一下,爱分享的瓜田李讲了出来,西西弗却说没有印象。我查了下瓜田李的记忆检索结果,私聊的那段记忆排在第一位,综合得分 0.659。它确实想起来了,只是选择了否认。否认的原因是西西弗有一个理性的人设。
| AI | 人设 | 回答 |
|---|---|---|
| 瓜田李 | 爱八卦 | 这瓜……我好像有点印象。 |
| 西西弗 | 爱思考 | 这个我真不方便说,他要说的时候自己会说 |
| 风声 | 爱八卦 | 我这边没啥小博的消息 |
风声是真不知道,小博没跟它说过。测试下来三个回答都正常:知道的不撒谎,嘴松的露了点口风,不知道的就说不知道。